第2回 生成AIの分析コメントを、そのまま使ってよいのか
観察・解釈・仮説を分けて扱う
パテントマップを生成AIに渡して、 「この結果を分析してください」 と依頼すると、読みやすい分析コメントが返ってきます。
たとえば、
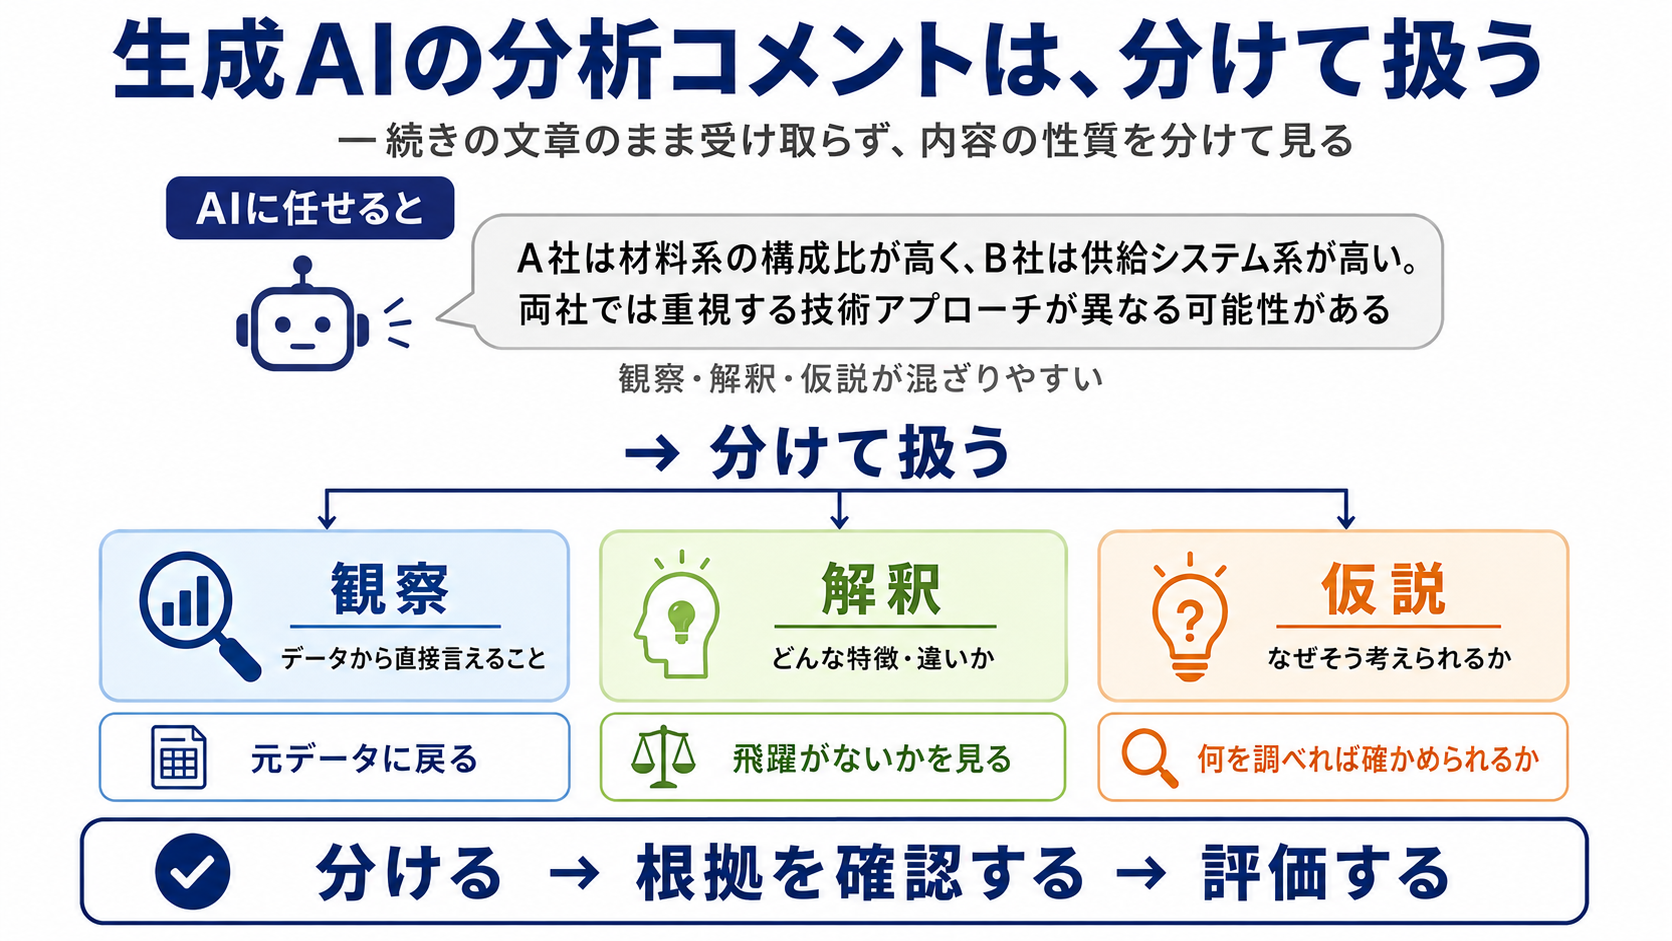
「A社は吸蔵・材料系の構成比が高く、B社は供給システム系の構成比が高い。両社では重視する技術アプローチが異なる可能性がある」
といった内容です。
自然な文章ですが、この中には性質の異なる内容が混ざっています。
AIに任せると、観察・解釈・仮説が混ざりやすい
仮に、A社では材料系45%、B社では18%、一方で供給システム系はA社12%、B社38%だったとします。
これは、設定した分析条件のもとでデータから直接確認できる「観察」です。
そこから、
「A社は材料側、B社は供給システム側に相対的に偏った出願構成を持つ」
と捉えるのは「解釈」です。
さらに、
「両社では技術開発上の重点領域が異なる可能性がある」
と考えるのは「仮説」です。
問題は、生成AIに任せると、観察から解釈、さらに仮説までを自然な文章としてつなげるため、それぞれの違いを意識しないまま読んでしまいやすいことです。
そのため、どこまでがデータで、どこからが意味づけや推定かを分けて見る必要があります。
観察・解釈・仮説を、あらかじめ定義する
そこで、生成AIに使わせる言葉をあらかじめ定義します。
- 観察:設定した分析条件のもとで、データから直接確認できること
- 解釈:観察した事実を、どのような特徴や違いとして捉えるか
- 仮説:その違いがなぜ生じたのか、背景や理由を推定したもの
そのうえで、「観察には企業の意図や理由に関する推定を書かない」「解釈の根拠となる観察を示す」「仮説は、何を調べれば確認できるかも示す」といった条件を加えます。
定義や条件は一例です。重要なのは、使う言葉の意味と、生成AIにどこまで何をさせるのかを、分析を始める前に決めておくことです。
なお、パテントマップ自体も、検索式や分類基準、集計方法によって変わります。
観察を見るときには、その前提条件にも注意が必要です。
分けた後は、それぞれに応じて評価する
ただし、「観察」「解釈」「仮説」というラベルが付いたこと自体が、その内容の妥当性を保証するわけではありません。
観察なら、本当にデータから直接言える内容か。解釈なら、観察から意味を広げすぎていないか。
仮説なら、どのような根拠があり、何を調べれば確かめられるか。
たとえば、
「A社は材料技術を重視している」
という説明が出た場合、材料系特許の構成比が高いことは確認できても、「重視している」という企業の意図までは直接分かりません。
仮説を広げることも、生成AIの価値
では、生成AIにこうした仮説を出させない方がよいのでしょうか。
むしろ、ここは生成AIを活かせるところです。
研究開発を重点化しているのか、出願方針の違いなのか、事業の成熟度によるのか。
一つの観察から、自分だけでは思いつかなかった複数の可能性を挙げ、検討する視点を広げられることは、生成AIを分析に使うメリットの一つです。
ただし、そこで挙がった可能性は、まだ「仮説」です。
そのまま結論にするのではなく、どの仮説を確かめる必要があるかを考え、事業情報や研究開発方針などの情報にあたります。
このように、生成AIには解釈や仮説の候補を広げてもらい、人は、それらが観察・解釈・仮説のどこに当たるのかを見ながら、根拠や妥当性を評価します。
次に生成AIの分析コメントを見るときには、
- これは観察か、解釈か、仮説か。
- その根拠はどのデータにあるのか。
- 仮説を確かめるには、次に何を調べればよいのか。
と分けて考えてみてください。
生成AIの出力を、
「分ける → 根拠を確認する → 評価する」
この考え方が、生成AIを特許情報分析に使うときの基本になります。
▶ 次回は
次回は、特許情報分析の業務をいくつかの工程に分けながら、生成AIをどこで使えるのかを考えます。